brm(
  y ~ 1 + x1 + x2 + (1 | g),
  data = benchmark, family = poisson(),
  iter = 4000, warmup = 2000,
  chains = 4, cores = 4,
  threads = if (k > 1) threading(k) else NULL,
  seed = 1234,
  prior = prior(normal(0, 1), class = b) +
          prior(constant(1), class = sd, group = g),
  backend = "cmdstanr",
save_pars = save_pars(all = TRUE))Bayes cu R și brms. Nu procesorul e problema…
brms
ro
cpu
bayes
mcmc
Gânduri și recomandări despre sistemele pe care rulează modelele Bayesiene în brms și Stan. Un mic benchmark pentru acasă.
Introducere
Partea computațională a inferenței Bayesiene poate fi uneori extrem de costisitoare. În special dacă modelele rulate au funcții de verosimilitate dificile ca de ex. cea negativ-binomială, sau dacă cumva sunt modele ordinale. Problema e că geometria dificilă a distribuției posterioare obligă lanțurile MCMC să facă pași mulți și mărunți când o explorează, așa că un procesor “bun” este binevenit. Dar ce înseamnă “bun”? Păi, probabil un timp real de execuție cât mai scurt până la estimare.
Deci un nucleu rapid ar fi de dorit, dar care e curba randamentului sau punctul de eficiență, care o dată atins nu justifică achiziția unui CPU “și mai bun”? Sau cât proverbial unt poți scoate din ceva mai vechi cu ajutorul paralelizării între nuclee și intra-lanțuri MCMC?
Pentru că am acces la diverse generații de procesoare sub diverse configurații, m-am gândit să le compar în concediu :) și cu ocazia asta să și scriu prima postare pe blog.
Candidații
| Calculator | Nuclee (performanță) | RAM | Sistem | Preț aprox. |
|---|---|---|---|---|
| HP ProBook 455 G9, Ryzen 5 5625U | 6 | 16 | Win / WSL2 | 500 € |
| Desktop, Ryzen 5 3600 | 6 | 32 | Win / WSL | sub 100 € (CPU, SH) |
| Mac mini M4 | 4 din 10 | 16 | macOS | 700–800 € |
| MacBook Pro M4 Pro | 8 din 12 | 24 | macOS | 1.700 € SH |
| MacBook Pro M4 Max | 12 din 16 | 36 | macOS | 4.000 € |
| Desktop, Ryzen 9 5950X | 16 | 128 | Ubuntu | ~250 € (CPU, SH) |
Benchmarkul
În primul rând avem nevoie de niște date și de un model. Ambele le-am luat pur și simplu de pe foarte buna vigneta a lui Sebastian Weber despre rularea modelelor brms cu ajutorul paralelizării intra-lanțuri MCMC.
Pe scurt, sunt niște date sintetice cu 10.000 de observații, grupate în 1000 de clustere. Modelul e un Poisson cu doi predictori, un intercept aleator și pante fixe, cu forma
Pentru cei curioși, detaliile le puteți găsi și pe pagina de github a benchmarkului, și dacă sunteți și mai curioși, puteți să rulați funcția voi și să îmi scrieți și mie ce valori primiți, împreună cu datele sistemului, și le pun “pe net”.
Cum am testat
Fiecare calculator a rulat același model, cu aceleași date și cu aceeași seed. Am rulat fiecare configurație de două ori. Prima rulare include compilarea modelului, a doua folosește executabilul deja compilat și scris pe disc. În tabelul de mai jos apare valoarea cea mai mică, adică rularea fără compilare.
Ce raportez aici este timpul mediu pe lanț. Am pornit de la 4 lanțuri în paralel, câte unul pe nucleu, apoi am adăugat threaduri în interiorul fiecărui lanț (threads = threading(k)), atât cât au permis nucleele de performanță. De exemplu, pe CPUurile cu 6 nuclee am folosit 3 lanțuri x 2 threaduri, ca să ocup toate nucleele. Pe celelalte, 4x2, sau 4x3 (5950)
Ce mai e de zis e că laptopurile au fost conectate la priză, iar în Linux am setat guvernorul procesorului pe performance. All set!
Rezultate
| Sistem | 1 thread | 2 threaduri | 3 threaduri | 4 threaduri |
|---|---|---|---|---|
| AMD 5625U (WSL2) | 89.8 s | 65.5 s (1.37×) | ||
| AMD 3600 (Win11 + WSL1) | 87.6 s | 58.9 s (1.49×) | ||
| AMD 5950X | 56.9 s | 36.4 s (1.56×) | 31.9 s (1.78×) | 26.2 s (2.17×) |
| Apple M4 | 47.5 s | |||
| Apple M4 Pro | 45.4 s | 32.9 s (1.38×) | ||
| Apple M4 Max | 45.1 s | 30.4 s (1.48×) | 27.6 s (1.63×) |
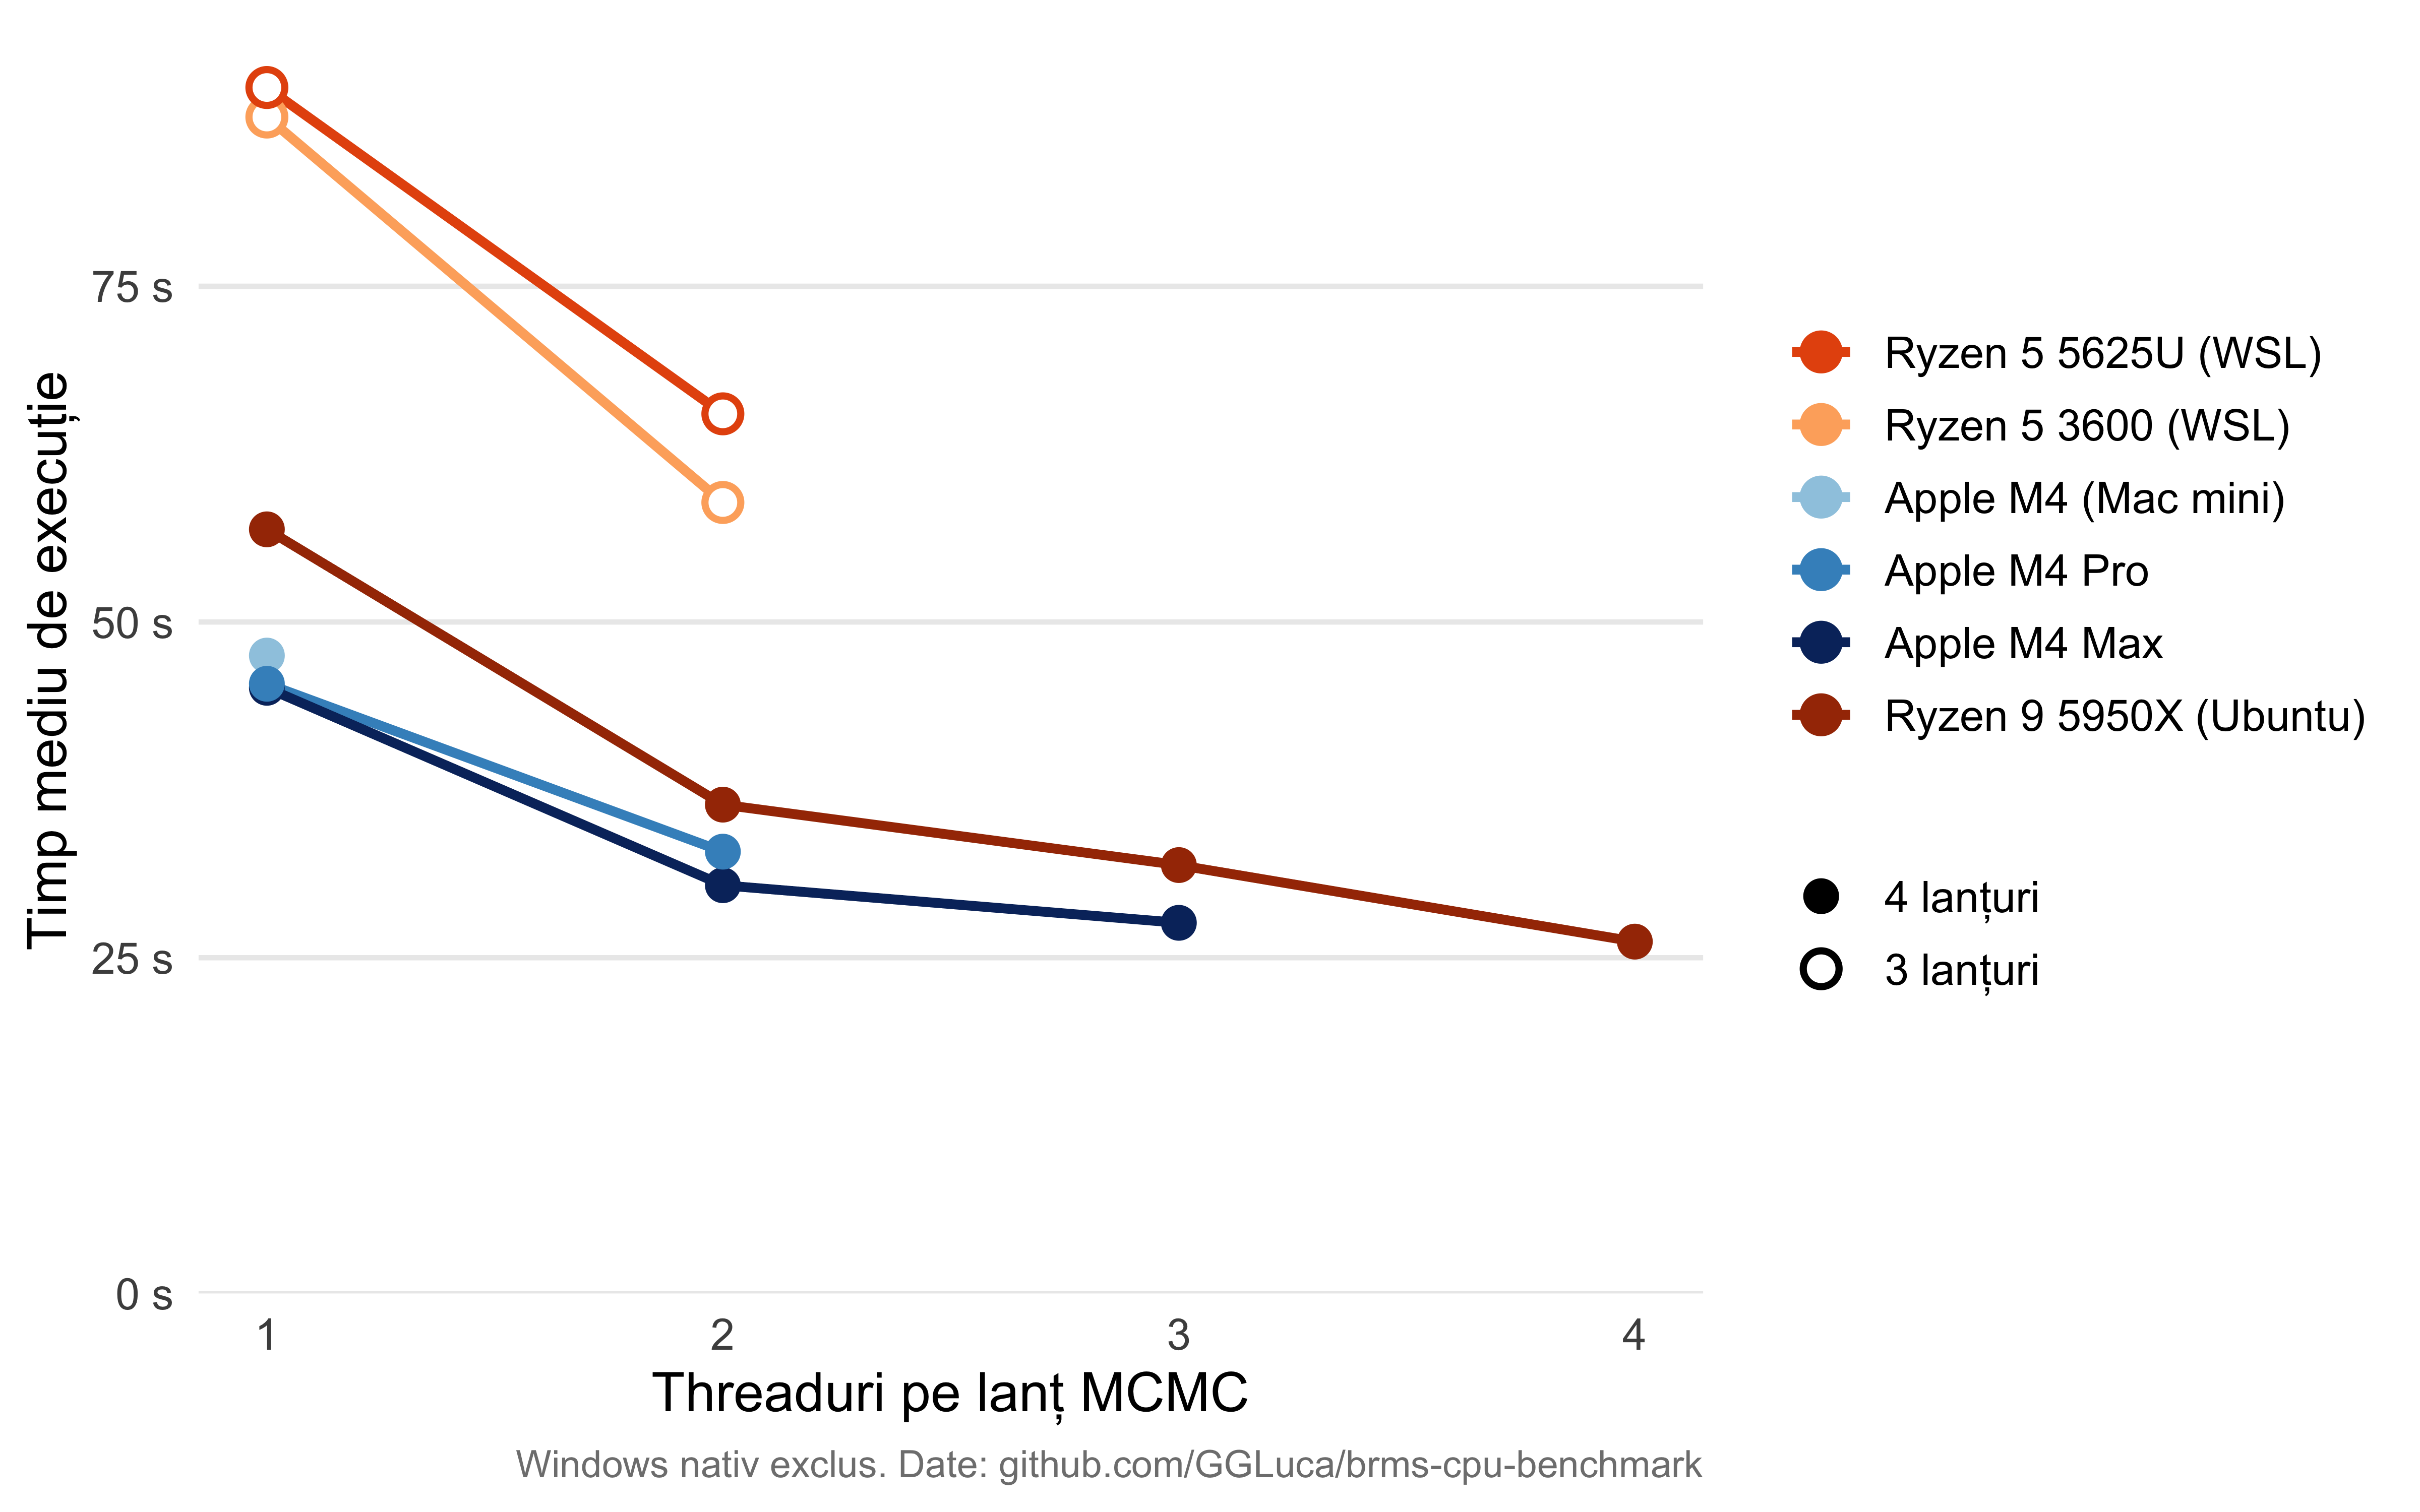
Și graficul aferent…
Concluzii…
După toate aceste zile de testări ideea e că, pe un singur nucleu, diferențele dintre procesoarele moderne sunt mult mai mici decât ar sugera prețurile. De exemplu, toate cele trei CPUuri de la Apple, M4, de la Mac Mini până la M4 Max, termină un lanț în aproximativ 45–48 de secunde, iar acel Mac Mini m-a costat (cu prima didactică, ce-i drept) 1500 RON. Dacă îl găsiți pe undeva la SH, eu zic că e arhisuficient pentru modelele obișnuite.
La fel, un Ryzen 9 5950X, care e un procesor de desktop din 2020, are nevoie de vreo 57 de secunde pt același model, dar are și un 105W TDP (poate chiar mai mult) în sarcină maximă. Ce a făcut Apple e de-a dreptul fascinant.
Diferența reală apare abia când folosesc nucleele rămase libere, prin threading(). Două threaduri pe lanț MCMC duc la un câștig de timp de aproximativ 1,4–1,6 ori pe toate sistemele, iar pe desktopul meu cu 16 nuclee, cu patru threaduri pe lanț, ajunge la 26! de secunde, care e chiar puțin mai repede decât M4 Max-ul de 4.000 de euro. Nice!
Și aș mai trage o concluzie și care e probabil cea mai importantă pt cei care rulează încă Windows. Sistemul de operare contează mai mult decât procesorul. Nu am atașat aici absolut toate datele dar pe același Ryzen 5 3600, același model durează 189 de secunde în Windows (11) nativ și 94 de secunde când CmdStan rulează prin Windows Subsystem for Linux (WSL). La fel și pentru laptopul HP, diferența e de 3,2 ori! Nu știu exact de ce, dar probabil acele .dll-uri în Windows își fac de cap cum vor ele.
Eu zic că soluția în Windows nu cere hardware nou pentru modele simple sau puțin mai complicate. Dacă modelul trece prin WSL, câștigul de timp e real.
Cam atât pt primul post! Happy modeling!